NV gpgpu指令发射
先给出一个沮丧的结论:NVIDIA 没有公开一张可以跨架构泛化的物理拓扑图,告诉我们负责派发的模块(Dispatch Unit)、容量有限的派发通路(Dispatch Port)和真正接收并处理操作的执行流水线或功能部件(execution pipeline / functional unit)究竟怎样相连——这恰恰是我最想知道的信息😞,我也没能窥探出来。想了解到这个粒度的,别耽误时间看下面的正文了。
本文(想)弄清什么
- 一个 warp 什么时候可以发射?
- Warp Scheduler、Dispatch Unit、派发通路和后端执行资源分别做什么,它们到底怎样相连?没有公开的 NVIDIA GPU 内部拓扑图,我目前只能解释每一代的数量关系🙁
selected是否等于issued(似乎没必要,但是等会儿会有解释🤣🤣🤣),Scheduler 能否在前一条指令尚未执行完成时选择并发射下一条。- 一个 Warp Scheduler 配几个 Dispatch Units?一个 Dispatch Unit 每拍能发几条?这些数量怎样限制每拍最多能发几条?
- 两条指令想在同一拍发出,需要几个dispatch port、dispatch path和哪些后端资源同时空闲?
- 同一拍发两条指令,也就是 dual issue代表什么?为什么不能据此反推内部有几条物理通路?
- FP64、MUFU 这类较窄的执行资源,可能要分几拍接收或处理一个 warp 的工作;这几拍忙在哪里?
- 一条指令要用多个后端执行部件,而它们又共享派发通路时,是否必然要多拍?
本文参考的资料可以分为三类:
- NVIDIA 的官方资料:NVIDIA 白皮书、官方架构演讲、CUDA/Nsight 官方文档。
- NVIDIA 工程师提供的信息:在官方论坛给出的高层级说明。
- 实验推断:论文作者基于微基准测试提出的逆向模型。
把资料分成这几类,是因为有些说法并没有官方材料或者实验佐证。例如,“依赖的功能单元在硬件中太少的指令需要经由同一个 dispatch port 发射多次,并在此期间阻止其他指令发射”,就是未经验证的猜想,不能当作结论。
一、一条warp instruction的生命周期
一条 warp instruction 的发射依赖
发射一条指令的依赖
1 | |
- resident warp:已经驻留在一个 SM 上、占用了运行资源的 warp。
- eligible warp:下一条指令目前具备所有发射条件、可以参加本拍warp scheuler仲裁的 warp。
- issue:发射。
- selected:Nsight 的采样语义,表示已经从某个 eligible warp中 issue 了一条指令。
- in flight:指令已经发射,正在流水线或队列里,但结果还不一定能用。
- consumer:会读取前面 producer(生产者)结果的后续指令。
selected 在 Nsight 里已经表示发射
在 Nsight 的精确定义中,selected 表示已经 issued(是否能够证明warp scheduler select warp和dispatcher 发射指令是不能分割的🤔):
- 在 Nsight Compute 的 Scheduler Statistics模型中,Scheduler 选择一个 eligible warp,并从该 warp issue 一条或多条指令。
- 在 Warp Stall Reasons的采样语义中,
selected明确定义为该 warp 被 micro scheduler 选中并已 issue 一条指令;not_selected则是 warp 虽 eligible,但本周期选择了别的 warp。
所以,不能把 Nsight 的 selected 解释成“Scheduler 已预选一条还未 issue 的指令,并让它长期排队”!!! 而且,收集到的公开资料也没有证明一个跨架构通用的 select-to-issue queue。不能据此说这里有类似 x86 CPU 的 uop queue,让 Scheduler 预先选择很多尚未 issue 的普通指令。
这不是在断言芯片内部绝对不存在任何缓冲。Volta 的官方 Hot Chips 图明确画有 MIO Queue。MIO 是 NVIDIA 对一类非 L1TEX 操作路径使用的名称,这个队列可以保存某类 MIO 指令供稍后调度;但它是特定路径上的公开队列,不能外推成所有 selected 指令共有的通用队列。对未公开的内部 pipeline register 或 queue,目前的结论还是:公开资料不足(当然也可以逆向)。
二、Scheduler、Scoreboard、Dispatch 和执行部件分别做什么
Warp Scheduler、Dispatch Unit、Dispatch Port 和执行流水线是什么关系
四者处在不同层次,不能互相当作同一个部件:
后面的逻辑图里,做算术运算的部件叫 ALU,做特殊函数的部件叫 SFU,负责加载和存储的访存部件叫 LSU。
| 部件 | 作用 |
|---|---|
| Warp Scheduler | 在分配给它的 resident warps 中检查候选,用调度统计的高层说法,就是选择一个 warp 当前可以发的下一条指令。 |
| Scoreboard | 跟踪尚未解除的动态依赖和部分顺序条件,让过早读取、覆盖或越过顺序的指令先等一等。 |
| Dispatch Unit | NVIDIA 公开架构图中承接派发的模块或能力;它把 Scheduler 选出的指令往后端送。 |
| Dispatch Port/path | 某类有限的派发入口、通路或带宽资源,不是 ALU 那种“做加法/乘法”的功能部件。 |
| Execution pipeline | 执行流水线,强调一条操作怎样分阶段进入和处理。 |
| Functional unit | 功能部件,强调真正做计算或访存的硬件,例如 ALU、SFU、LSU。下文不需要细分时,把两者合称“后端执行资源”。 |
下面的图只表示调度语义上的逻辑关系,不是 NVIDIA 已公开的物理拓扑:
1 | |
- Warp Scheduler 在统计模型里选的是某个 warp 当前可以发射的下一条指令。Volta 以后,同一 warp 的线程可以位于不同程序位置;
- Dispatch Unit 是公开框图里的派发模块,但 Dispatch Unit 和 Dispatch Port 是否一一对应,暂时未知。
- Dispatch Port/path 是对有限派发入口、通路或共享带宽的资源描述,不是物理部件。
- Execution pipeline 和 functional unit 不是完全同义词。前者强调分阶段接收和处理,后者强调真正完成计算或访存;本文统称它们为“后端执行资源”。一次能处理多少 lane、隔多久能接下一条工作、多久以后结果能用,也是三个不同属性。
这几层可以记成:
1 | |
Dispatch Unit 和 Dispatch Port 有关系吗
有逻辑关系,可以粗略类比:
1 | |
但在 NVIDIA 的语境里,这个类比不能机械化。公开资料没有证明 1 个 Dispatch Unit = 1 个物理 Dispatch Port。一种可能是,一个 Dispatch Unit 能走多条派发通路:
1 | |
另一种可能是,多个派发来源共用一条通路:
1 | |
更严谨的说法是:Dispatch Port 是 Dispatch Unit 执行派发时可能使用和争用的有限路径资源;两者是否一一对应、port 位于 DU 内部还是后端入口处,公开资料通常没有说明。
Dispatch Port 和后端执行部件有关系吗
也有逻辑关系。Dispatch Port/path 决定指令能否被送往相应的 execution pipeline。概念上可能是:
1 | |
某些执行流水线可能各走不同路径:
1 | |
也可能多个后端共用某一级派发能力:
1 | |
三、一条指令的发射条件
一条指令的所有发射依赖
公开资料足以说明,一条指令的发射会同时受数据依赖和后端资源可接受性约束;但资料不足以恢复 Warp Scheduler → Dispatch Unit → Dispatch Port → execution pipeline 的完整物理连线。
1 | |
最好有实际的证据,Nsight 就对发射的阻塞原因做了细致的 profiling,所以我们直接从 Nsight 的手册入手。Nsight Compute Profiling Guide 对 eligible warp 的高层描述明确包含:指令已解码、输入依赖已解除,以及 function unit 可用。常见状态和阻塞原因包括:
long_scoreboard/short_scoreboard:warp 正等待某个 producer 的依赖条件解除。math_pipe_throttle:warp 正等待 execution pipe 可接受新工作。dispatch_stall:指令已 ready,但 dispatcher 因其他冲突或事件暂不发射。barrier:warp 正等待 CTA 同步条件。not_selected:warp 已是 eligible 候选,但本拍仲裁结果是其他 warp。selected:已经 issue 指令。
这些是性能分析器给出的语义分类,不是物理连线探针。尤其不能拿一个 stall 指标,反推出“某个 Dispatch Unit 必然连着某个物理 port”。
Scoreboard 负责什么
Scoreboard 不能简单概括为“记录一个 warp 内的所有数据依赖”,也不只是一张“寄存器 ready bit 表”。Nsight Compute 的 Instructions & Dependencies 文档说明,scoreboard 用于协调:
- RAW(read after write,真数据依赖):consumer 不能在 producer 的结果可用前读取它。
- WAR(write after read,反依赖):后续 writer 不能过早覆盖仍在被先前操作读取的状态。
- state update(状态更新):某些操作完成前,与其状态更新相关的后续操作需要等待。
- instruction-level memory ordering(指令级内存顺序):协调需要由 scoreboard 表达的指令间内存顺序关系。
在公开可观察的抽象中,scoreboard 建立的是 scoreboard producer → scoreboard consumer 关系:
1 | |
寄存器结果是最常见的例子:
1 | |
注意:普通寄存器是 thread-private 的,因此 consumer 等待的直接 scoreboard producer 通常是同一 warp 先前发射的操作。但数据内容不一定由当前 warp 创建:
1 | |
R4 的数据可以由 W1 经 shared memory 提供,但 W0 的 scoreboard 直接跟踪的是 LDS → IADD,不是一条 W1.STS → W0.IADD 的跨 warp 寄存器依赖边。W1 与 W0 之间的到达和可见性由 shared-memory ordering 与 BAR.SYNC 保证。
long_scoreboard 和 short_scoreboard 主要区分 producer 路径,不是一条通用的 cycle 阈值:
long_scoreboard:等待 L1TEX 路径上的 local/global/surface/texture 操作产生的 scoreboard dependency。L1TEX 是一级缓存、纹理和相关访存操作经过的路径。short_scoreboard:等待非 L1TEX 的 MIO 操作产生的 scoreboard dependency,常见于 shared memory,也可见于 MUFU 和某些动态分支。
“barrier”需要区分:
- thread synchronization barrier,例如
BAR.SYNC/BAR.WARP.SYNC,等待线程或 warp 到达;它不是普通 scoreboard dependency。 - instruction dependency barrier/token,表示某个先前操作尚未完成;它属于 scoreboard 式的依赖跟踪。
大白话说,Scoreboard 记着这个 warp 还有哪些前置工作没完成。它会拦住仍有 RAW、WAR、状态更新或指令级内存顺序条件没有解除的后续指令。它主要跟踪 producer 和 consumer 之间这些动态依赖,不负责线程是否都到达同步点,也不负责执行流水线容量和 dispatch 仲裁。它更不是完整的 CUDA 内存一致性模型。
Scheduler 如何得到所需信息
不是 Warp Scheduler 维护所有状态。各模块会告诉调度器“依赖好了没有”“同步条件到了没有”“后面现在接不接得下”。下面这些名字只是本文的逻辑示意,不是 NVIDIA 公布的真实信号名:
1 | |
这些信号如何在电路上分层、是组合逻辑还是跨流水级传递,公开资料没有给出跨架构答案。Scheduler 和 Dispatch 在职责上确实分开:Scheduler 决定“选谁去发射”,Dispatch决定“这条路能否接受并将它送往哪里”。但不能由此假定中间存在一个通用、足够深的 issue queue,让 Scheduler 不理会后端限制而持续预选指令。
1 | |
在 Nsight 语义中,selected 已经表示被选中并 issue。Volta 官方图确实画出了特定的 MIO Queue,但这不能证明所有 math 指令都经过一个同类通用队列。
选择下一 warp、共享 port、双发和单指令使用两个功能单元
- Warp Scheduler 选中一个 warp 后,不必等到 issue 此指令,就可以再选下一个 eligible warp 吗:在 Nsight 定义中,
selected已经表示该 warp issued an instruction;没有公开的通用“selected 但尚未 issue”状态或队列,所以我们不能猜测warp scheduler选中一条指令后,先挂着,dispatch unit之后再issue。 - 不同功能单元共用 Dispatch Port,是否意味着这些指令要竞争发射机会:如果两条指令确实必须使用同一个、每周期只能接受一条指令的 path,它们就要竞争。但“不同功能单元共用同一物理 port”本身也需要具体架构证据。
- 如果一条指令用到不同功能单元,而且它们共用一个 Dispatch Port,是否要两个 cycle:不一定。拍数取决于 port transaction 数量和每拍接受能力,第四章会单独拆开。
- 两条指令使用不同功能单元,为什么仍可能共享同一 Dispatch Port:功能单元不同,只说明最终执行位置不同;它们仍可能共享上游派发入口、操作数路径或仲裁资源。具体 NVIDIA 连线未公开,不能把这种可能性画成已经确认的拓扑。
- 两条指令同时发射,使用多个 Dispatch Units 后是否就不会占用同一 Dispatch Port:不保证。即使有多个 Dispatch Units,两条指令仍可能因共享 path、目标 pipeline、源操作数路径或 pairing rule(哪些指令组合允许同拍配对)冲突而不能双发。
四、multi-cycle
讨论 FP64、MUFU 或任何“多周期”指令时,至少要分清下面四个metric:
- 结果可用延迟(result-use latency):producer 发射后,过多少拍它的结果才能被 dependent consumer 使用。
- 相邻同类指令进入间隔(initiation interval):同一条 pipeline 隔多少拍能接收下一条同类独立指令。
- 平均吞吐(throughput):稳定运行时,单位时间平均完成或接受多少工作。
- dispatch path/port 占用时间:同一条指令到底让某条派发路径连续多少拍不能接别的工作。
一个 32-thread warp 的 FP64 指令遇到一条每拍只能处理 8 lanes 的窄流水线时,multi-cycle行为可能来自三种不同实现:
1 | |
一条指令的两个功能单元共享同一 port 时究竟需要几拍
关键在于:一条指令通过这个 port 需要产生几次 transaction,以及 port 每拍能接受几次 transaction。transaction 在这里就是一次经过该路径、被路径接受的传输单位。通用公式是:
1 | |
ceil 表示向上取整。但 NVIDIA 通常没有公开这里的 transaction 数量和 port 容量,所以公式不能凭空给出具体拍数。
一种实现是“一次 transaction 后扇出”:
1 | |
时序可能是:
1 | |
此时从 SASS 高层视角看仍是一条指令,dispatch path 可能只使用 1 拍,A/B 后端随后各自执行很多拍。尽管两个功能单元“共享这个 port”,也不意味着必须经过两次。
另一种实现是“两个 micro-op 串行通过单容量 port”。micro-op 是一条指令在芯片内部拆出的更小操作:
1 | |
如果两个 micro-op 必须分别经过该 port,时序可能是:
1 | |
这时该通路至少要用 2 拍来接收这些内部操作。但外部看到的仍然可能只是一条 SASS 指令;第二拍不代表程序里又出现了一条新的 SASS 指令。至于 profiler 怎样统计 selection、哪一级保存这条指令,公开资料没有说明。
所以,只有同时证明“该指令产生两个 port transactions”和“该 shared port 每拍容量为 1”,才能得出“至少两拍”。“使用两个功能单元”本身不足以得出这个结论!
五、一拍能发射几条指令
issue width、dual issue
issue width 是一个 Scheduler/dispatch unit在一拍内最多能发射多少条指令。dual issue 是一拍发射两条指令。
同拍发两条,只表示两条兼容的指令在这一拍都成功发了出去;它本身没有告诉我们内部用了几条物理通路。
Dispatch Unit 的每周期能力、数量关系和多周期行为
- 一个 Dispatch Unit 一个 cycle 发送一条指令:一个 Dispatch Unit 是否每 cycle 发送一条:没有跨架构统一答案。GP100 每个 processing block 是 1 个 Scheduler、2 个 Dispatch Units,并公开每 Scheduler 每 clock 最多 dispatch 两条 warp instructions;Volta 的 Math Dispatch Unit 标为
1 Warp Inst/clk;Turing、A100、Hopper 等官方图通常标32 thread/clk。 - 为什么 Scheduler 和 Dispatch Unit 不总是 1:1:官方公开了模块数量和 dispatch width,没有公开选择
1:2或1:1的电路、面积、功耗理由。 - 窄流水线可能让一个 warp 跨多拍 selected and dispatched。内部每拍传的是 lanes、micro-ops 还是其他表示,哪一级保存状态、怎样统计 selection,都没有公开。
- Dispatch Port不是功能单元的端口,port 可以表示某个共享派发入口或路径,但公开资料没有给出通用的
Dispatch Unit → Dispatch Port → functional unit固定连线。只能使用具体架构已经画出的逻辑路径。
dual issue
目前可参考的资料有两类:
- NVIDIA 官方:Maxwell Tegra X1 和 Pascal GP100 宣称每 Scheduler 每 clock 可 dispatch 两条 warp instructions。
- 原始研究中的逆向报告:Volta 微基准报告 §2.1称,Maxwell/Pascal control encoding 的 stall/yield bit 组合可让一个 processing block 的两个 dispatch units 同时 dispatch 同一 warp 的两条相邻指令;作者又称在 Volta 生成代码中未观察到 dual issue。
dual issue是发射同一warp的两条指令还是发射多个warp的不同指令,不能确定:
- Maxwell/Pascal 的逆向报告说的是同一 warp 的两条 consecutive instructions,也就是相邻指令。
- Nsight 的表述是被选 warp 发射“一条或多条指令”。
六、不同 NVIDIA 架构分别公开了什么
下面的公开图只能展示模块数量,不能证明物理 port 怎样连。
Maxwell:Tegra X1
Tegra X1 Maxwell whitepaper,第 14 页 Figure 9把一个 SM 分成四个 32-CUDA-core processing blocks;每个块画出 1 个 Warp Scheduler、2 个 Dispatch Units、1 个 Register File,以及 Core、LD/ST、SFU。文中称每个 Scheduler 每时钟可为一个 warp dispatch 两条指令。
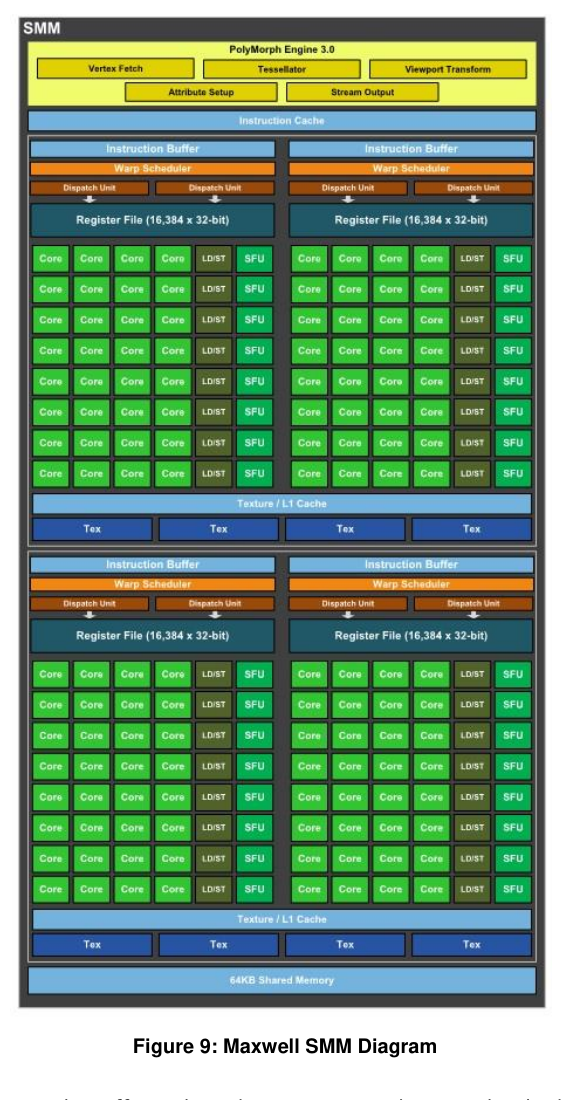
就这份白皮书描述的 Tegra X1 Maxwell SMM 而言,每个相关 processing block 是 1 Scheduler + 2 Dispatch Units,正文也明确写了每 Scheduler 每 clock 两条指令。Figure 9 没有 Dispatch Port 标签,也没有画出 Dispatch Unit 到执行单元的可达集合或仲裁线;“每时钟两条”也不代表任意两条 opcode 都能配对。
Pascal:GP100
Pascal GP100 whitepaper,第 12 页正文和第 13 页 Figure 8说明:一个 GP100 SM 有两个 processing blocks;每块含 32 个 FP32 CUDA Cores、instruction buffer、1 个 Warp Scheduler 和 2 个 Dispatch Units。每个 Scheduler 每时钟可以 dispatch 两条 warp instructions。
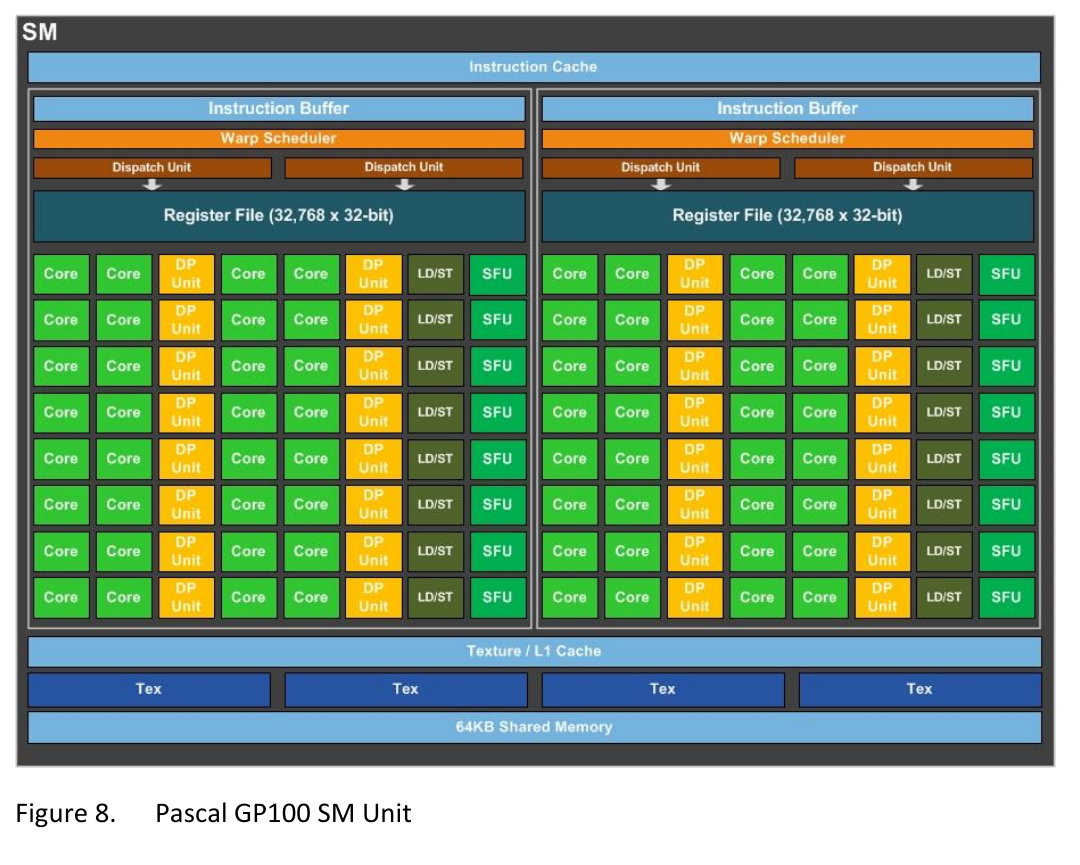
GP100 资料公开了 1 Scheduler : 2 Dispatch Units,也公开了每 Scheduler 每时钟两条 dispatch。两个 Dispatch Units 各能访问哪些 pipeline、是否共享入口、能否接受任意 opcode pair,这张图都没有回答。
Volta:GV100
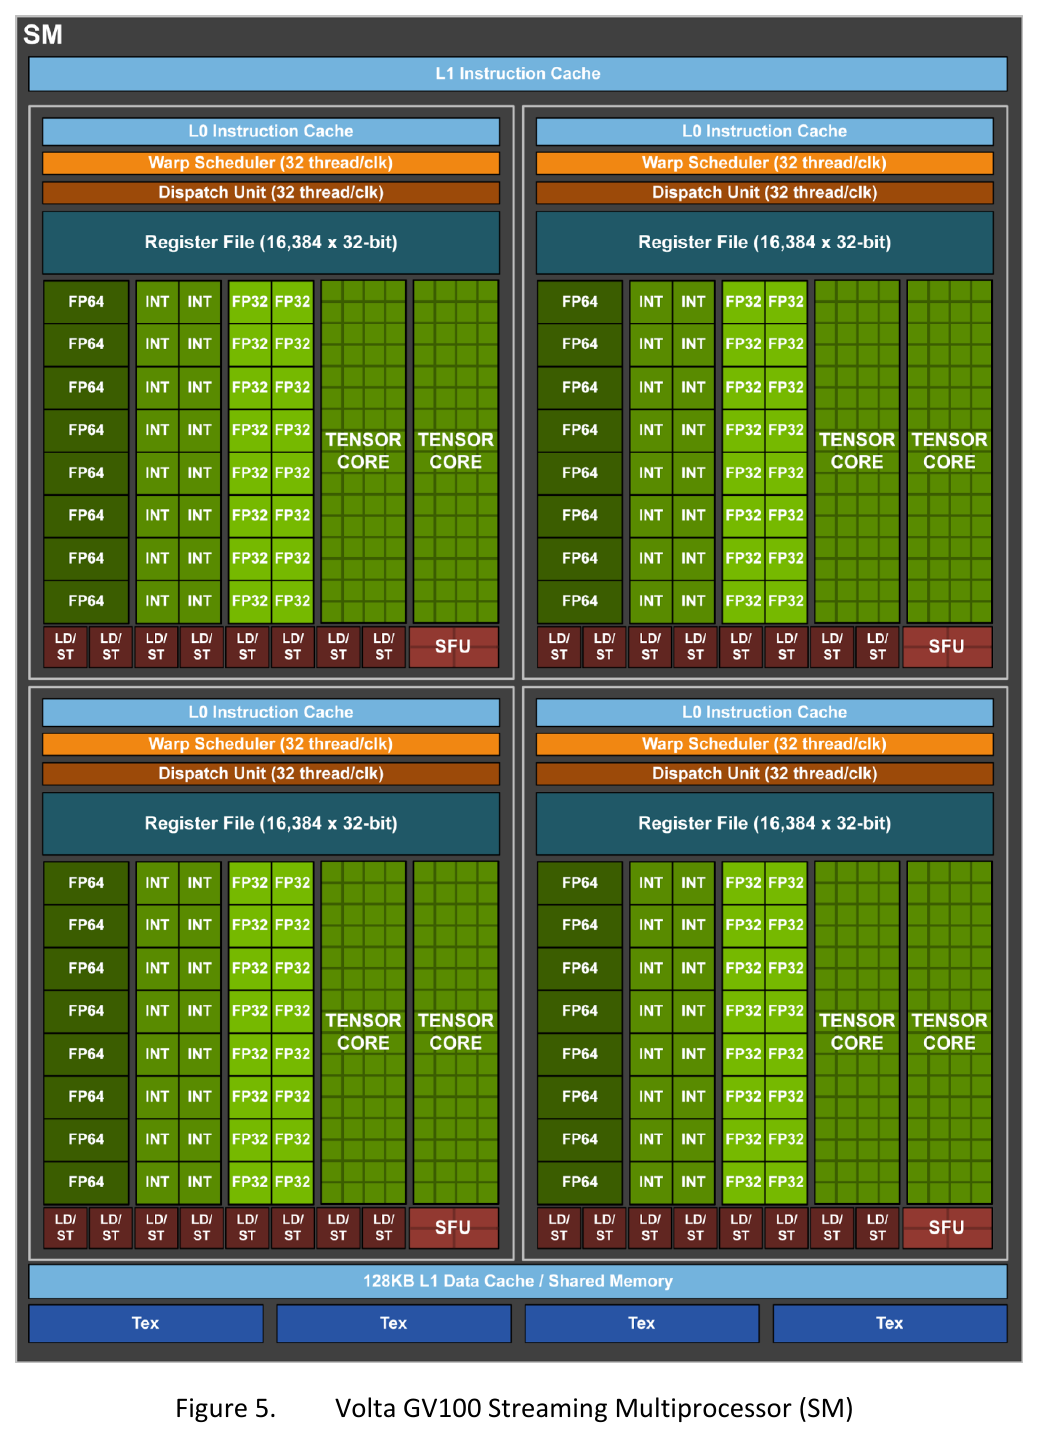
Volta GV100 whitepaper,第 12–13 页、Figure 5说明 GV100 SM 有四个 processing blocks;每块含 16 FP32、8 FP64、16 INT32、2 Tensor Cores、L0 instruction cache、1 Warp Scheduler、1 Dispatch Unit 和 64 KB Register File。图中 Scheduler 与 Dispatch Unit 均标为 32 thread/clk。
NVIDIA 的 Volta Hot Chips 29 演讲,slide 11进一步给出 GV100 一个 sub-processor block 的局部路径:Warp Scheduler 为 1 Warp Inst/clk,Math Dispatch Unit 为 1 Warp Inst/clk;图中 Math Dispatch Unit 指向 FP64、INT、FP32、MUFU,并标出 FP64 8 DFMA/clk、INT 16/clk、FP32 16 FFMA/clk、MUFU 4/clk。该 slide 还画出 Warp Scheduler → Tensor Core,Tensor Core 标为 two 4×4×4 tensor/clk;另一条路径为 Warp Scheduler → MIO Queue → MIO Scheduler,MIO Scheduler 标为 1 Warp Inst / 2 clk。
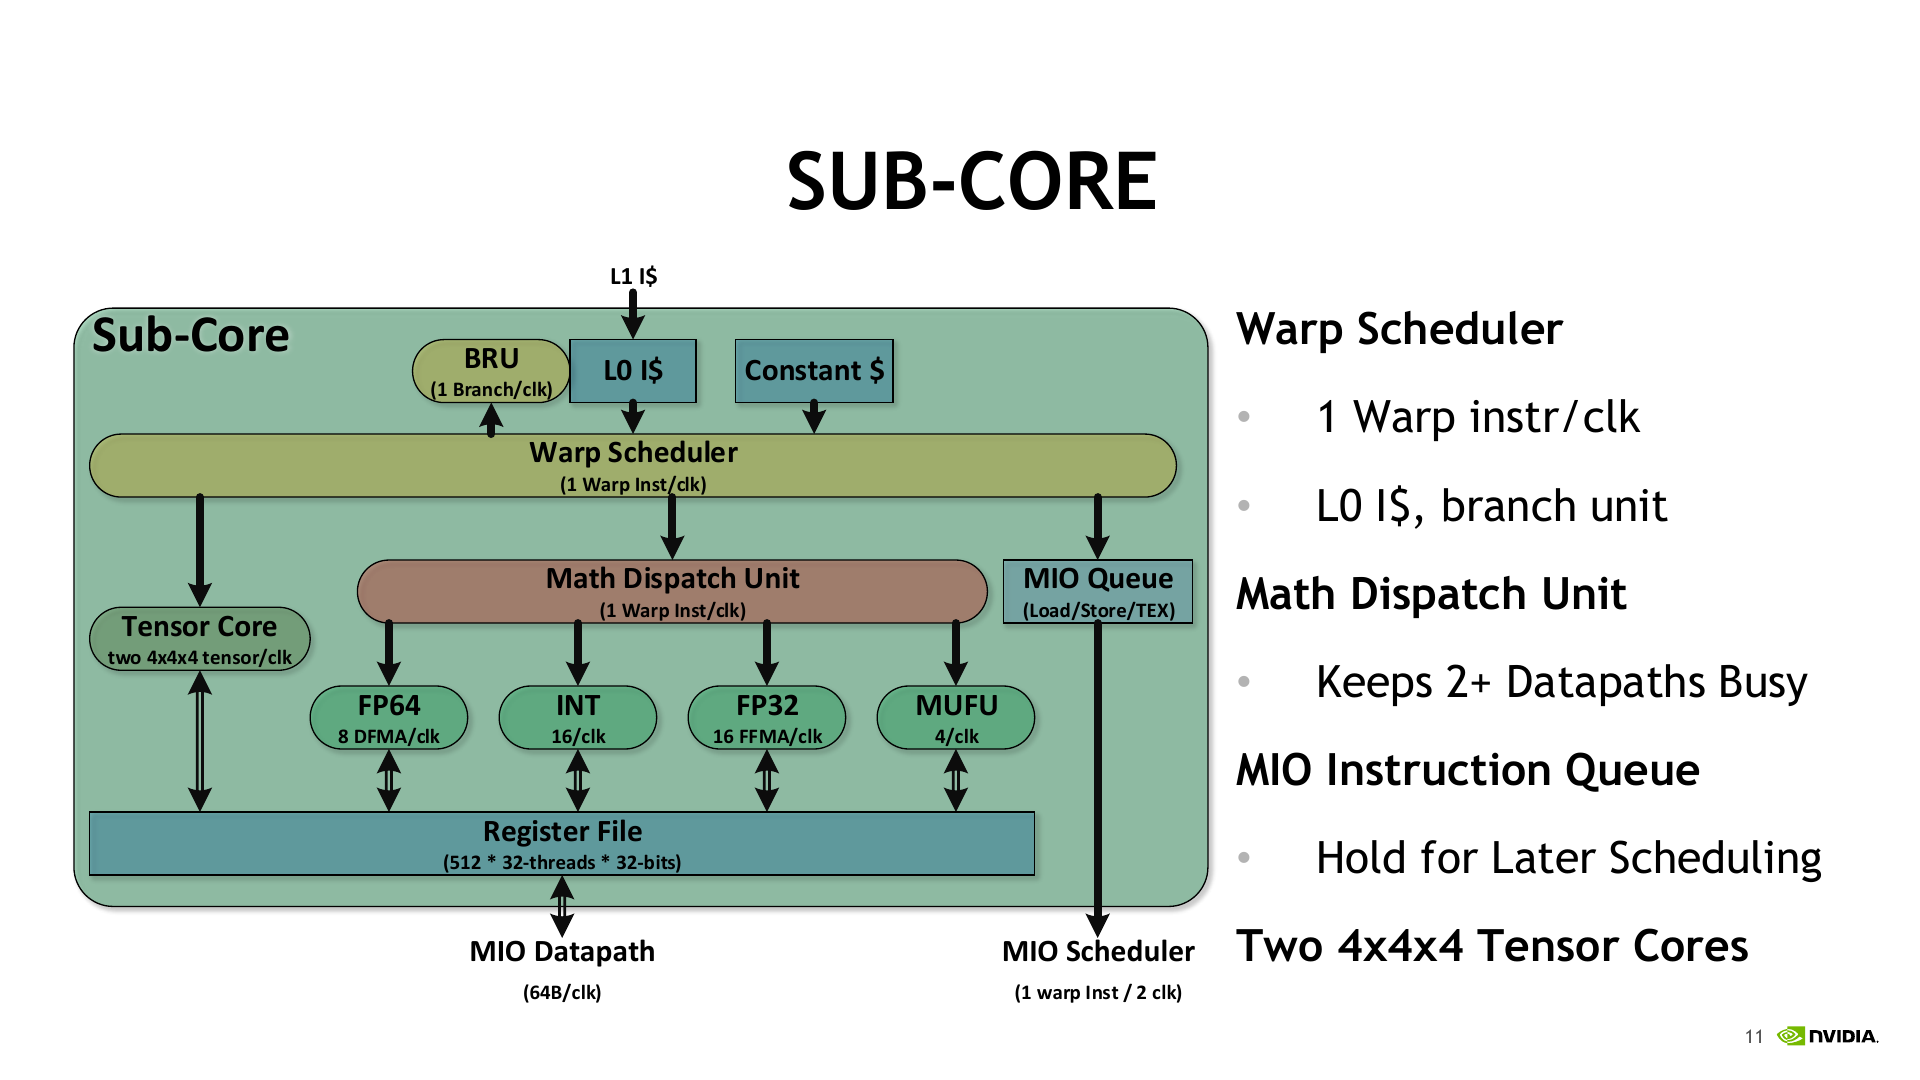
这两张 Volta 图比其他代多公开了一步:Hot Chips 图确实画了局部 dispatch 路径和特定的 MIO Queue,也标出了若干模块速率。但图上没有名为 Dispatch Port 的模块,没有说明箭头对应哪些物理 port,也不能把 MIO Queue 外推成所有指令共用的 select-to-issue queue。
Turing
Turing whitepaper,第 11–12 页、Figure 4说明 Turing SM 也分成四个 processing blocks;每块有 16 FP32、16 INT32、2 Tensor Cores、1 Warp Scheduler、1 Dispatch Unit、L0 instruction cache 和 64 KB Register File。正文说明独立 INT32 execution unit 可以与 floating-point math 并行执行。
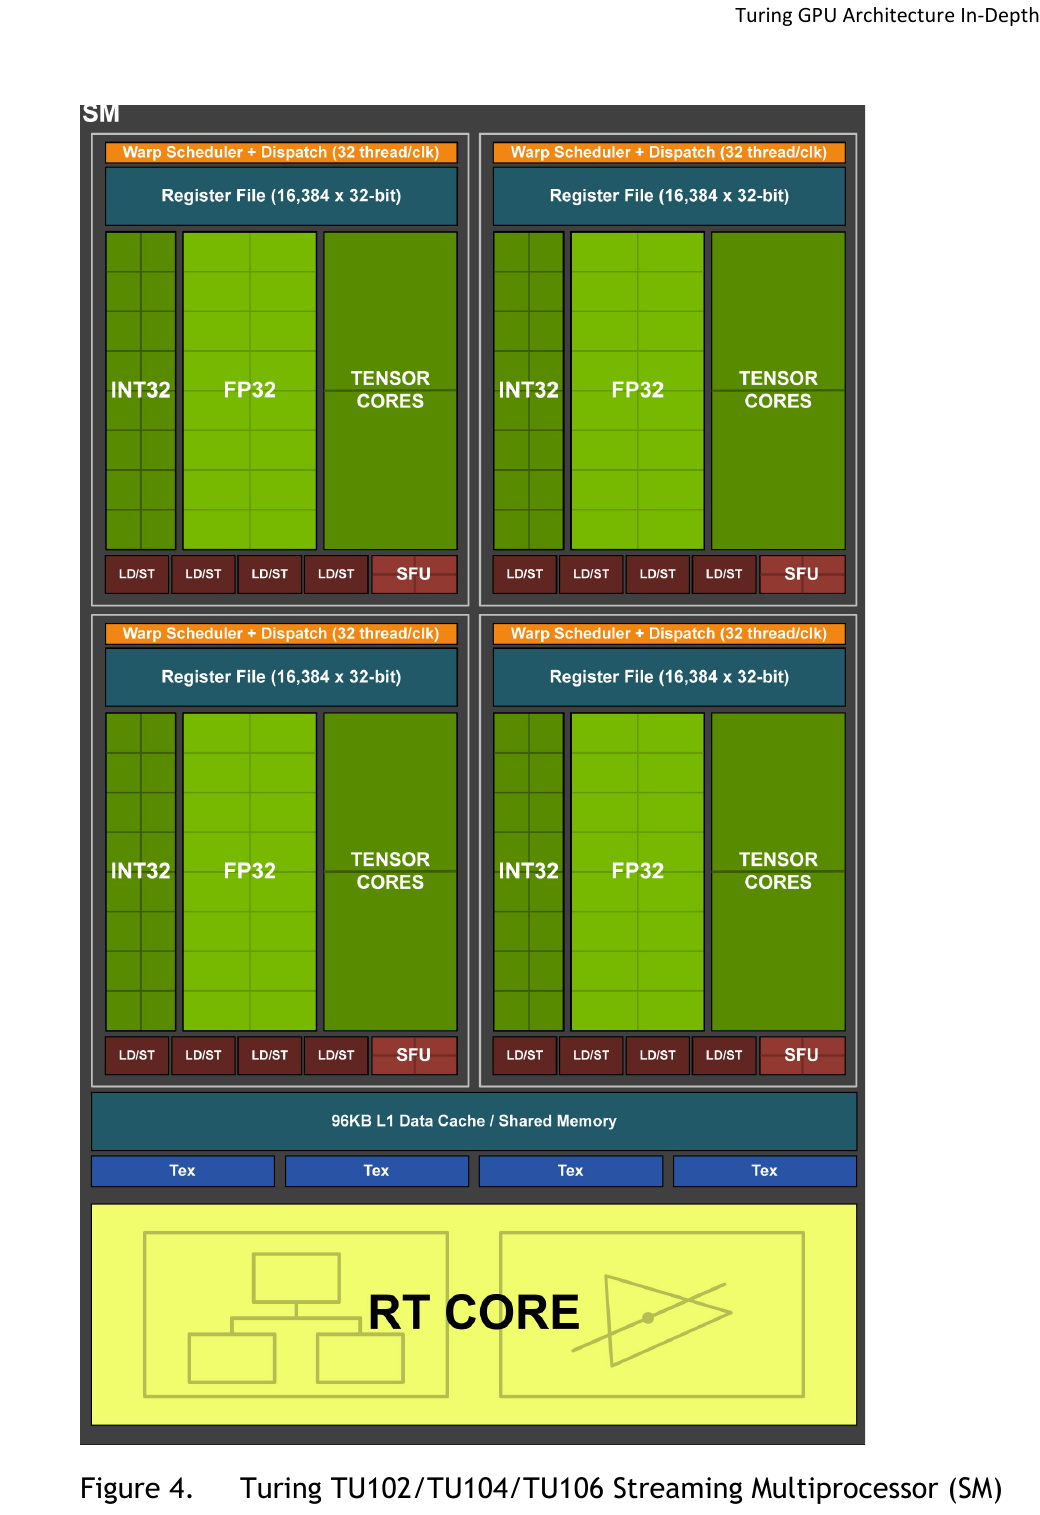
Turing 公开为每个 processing block 1 Scheduler + 1 Dispatch Unit,正文还支持独立 INT32 与浮点后端并行。不过后端能并行,不等于所有 INT/FP 指令对都能同周期 issue;图中也没有 port 数量和路由。
Ampere:A100
A100 whitepaper,第 20、22 页、Figure 7画出 GA100 SM 的四个重复面板;每个面板列 1 个 Warp Scheduler(32 thread/clk)、1 个 Dispatch Unit(32 thread/clk)、1 个 16,384×32-bit Register File,以及 INT32、FP32、FP64、Tensor Core、LD/ST 和 SFU。
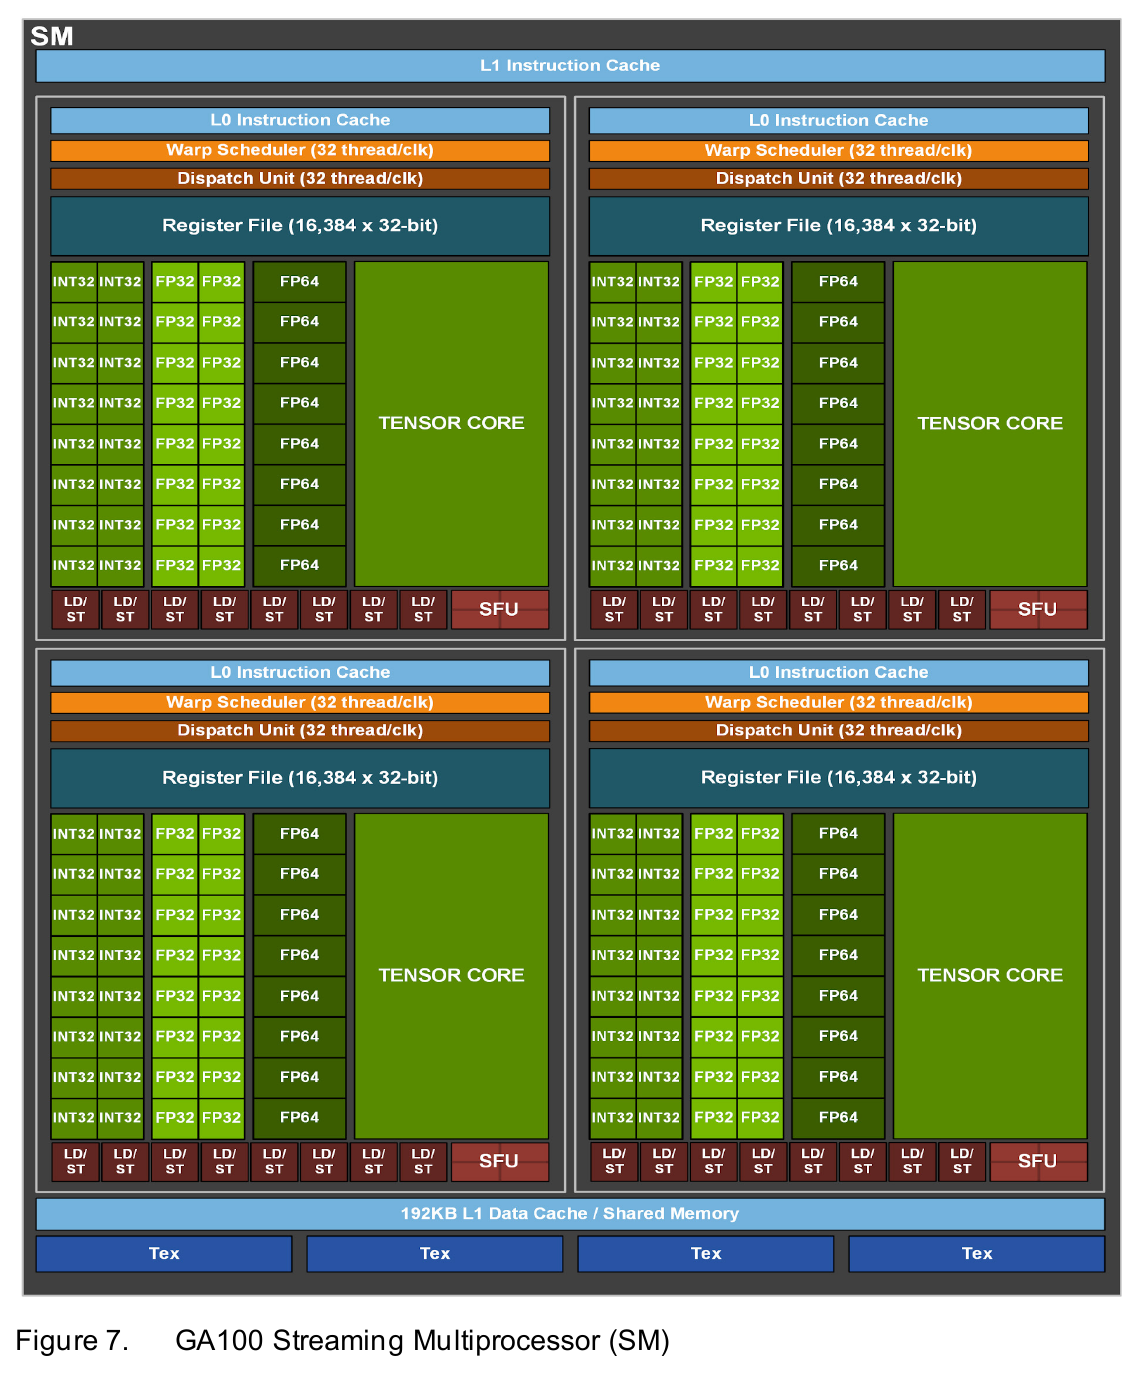
GA100 图能确认每个重复面板列出 1 Scheduler + 1 Dispatch Unit 及相应后端资源。方框的排列仍不是物理连线,不能拿来数 port 或推断同拍配对规则。
Hopper:H100
Hopper architecture in-depth,Figure 4的 GH100 SM 图也有四个重复块;每块列 1 个 Warp Scheduler(32 thread/clk)、1 个 Dispatch Unit(32 thread/clk)、1 个 16,384×32-bit Register File,以及 INT32、FP32、FP64、第四代 Tensor Core、LD/ST、SFU。SM 级还列出 TMA 与 256 KB L1/shared memory。TMA 是 Tensor Memory Accelerator,用来搬运多维 tensor 数据。
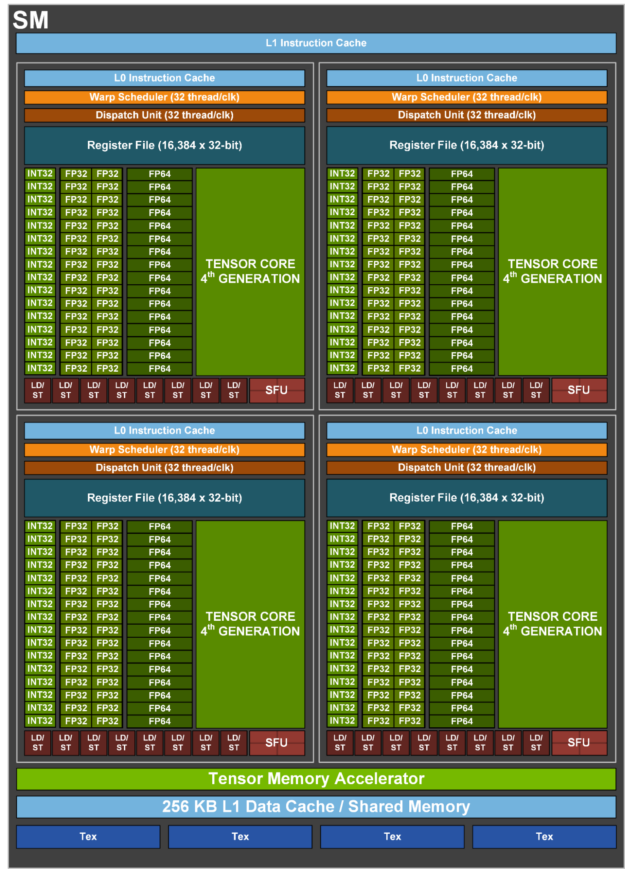
GH100 图确认了上述块级模块和容量标注,但没有画出 Dispatch Unit 到各 pipeline 的物理 port 连线;也不能只看 32 thread/clk,就推出任意 opcode 的实际发射率或吞吐。
Blackwell:Blackwell Ultra
Inside NVIDIA Blackwell Ultra,Figure 2称其 SM 包含 128 CUDA Cores、4 个第五代 Tensor Cores、256 KB TMEM 和 SFU;图中四个重复块各列 1 个 Warp Scheduler(32 thread/clk)、1 个 Dispatch Unit(32 thread/clk)、1 个 16,384×32-bit Register File、64 KB TMEM,以及 CUDA Cores、Tensor Cores、LD/ST、SFU。TMEM 是 Tensor Memory,是给 Tensor Core 路径使用的片上专用存储。
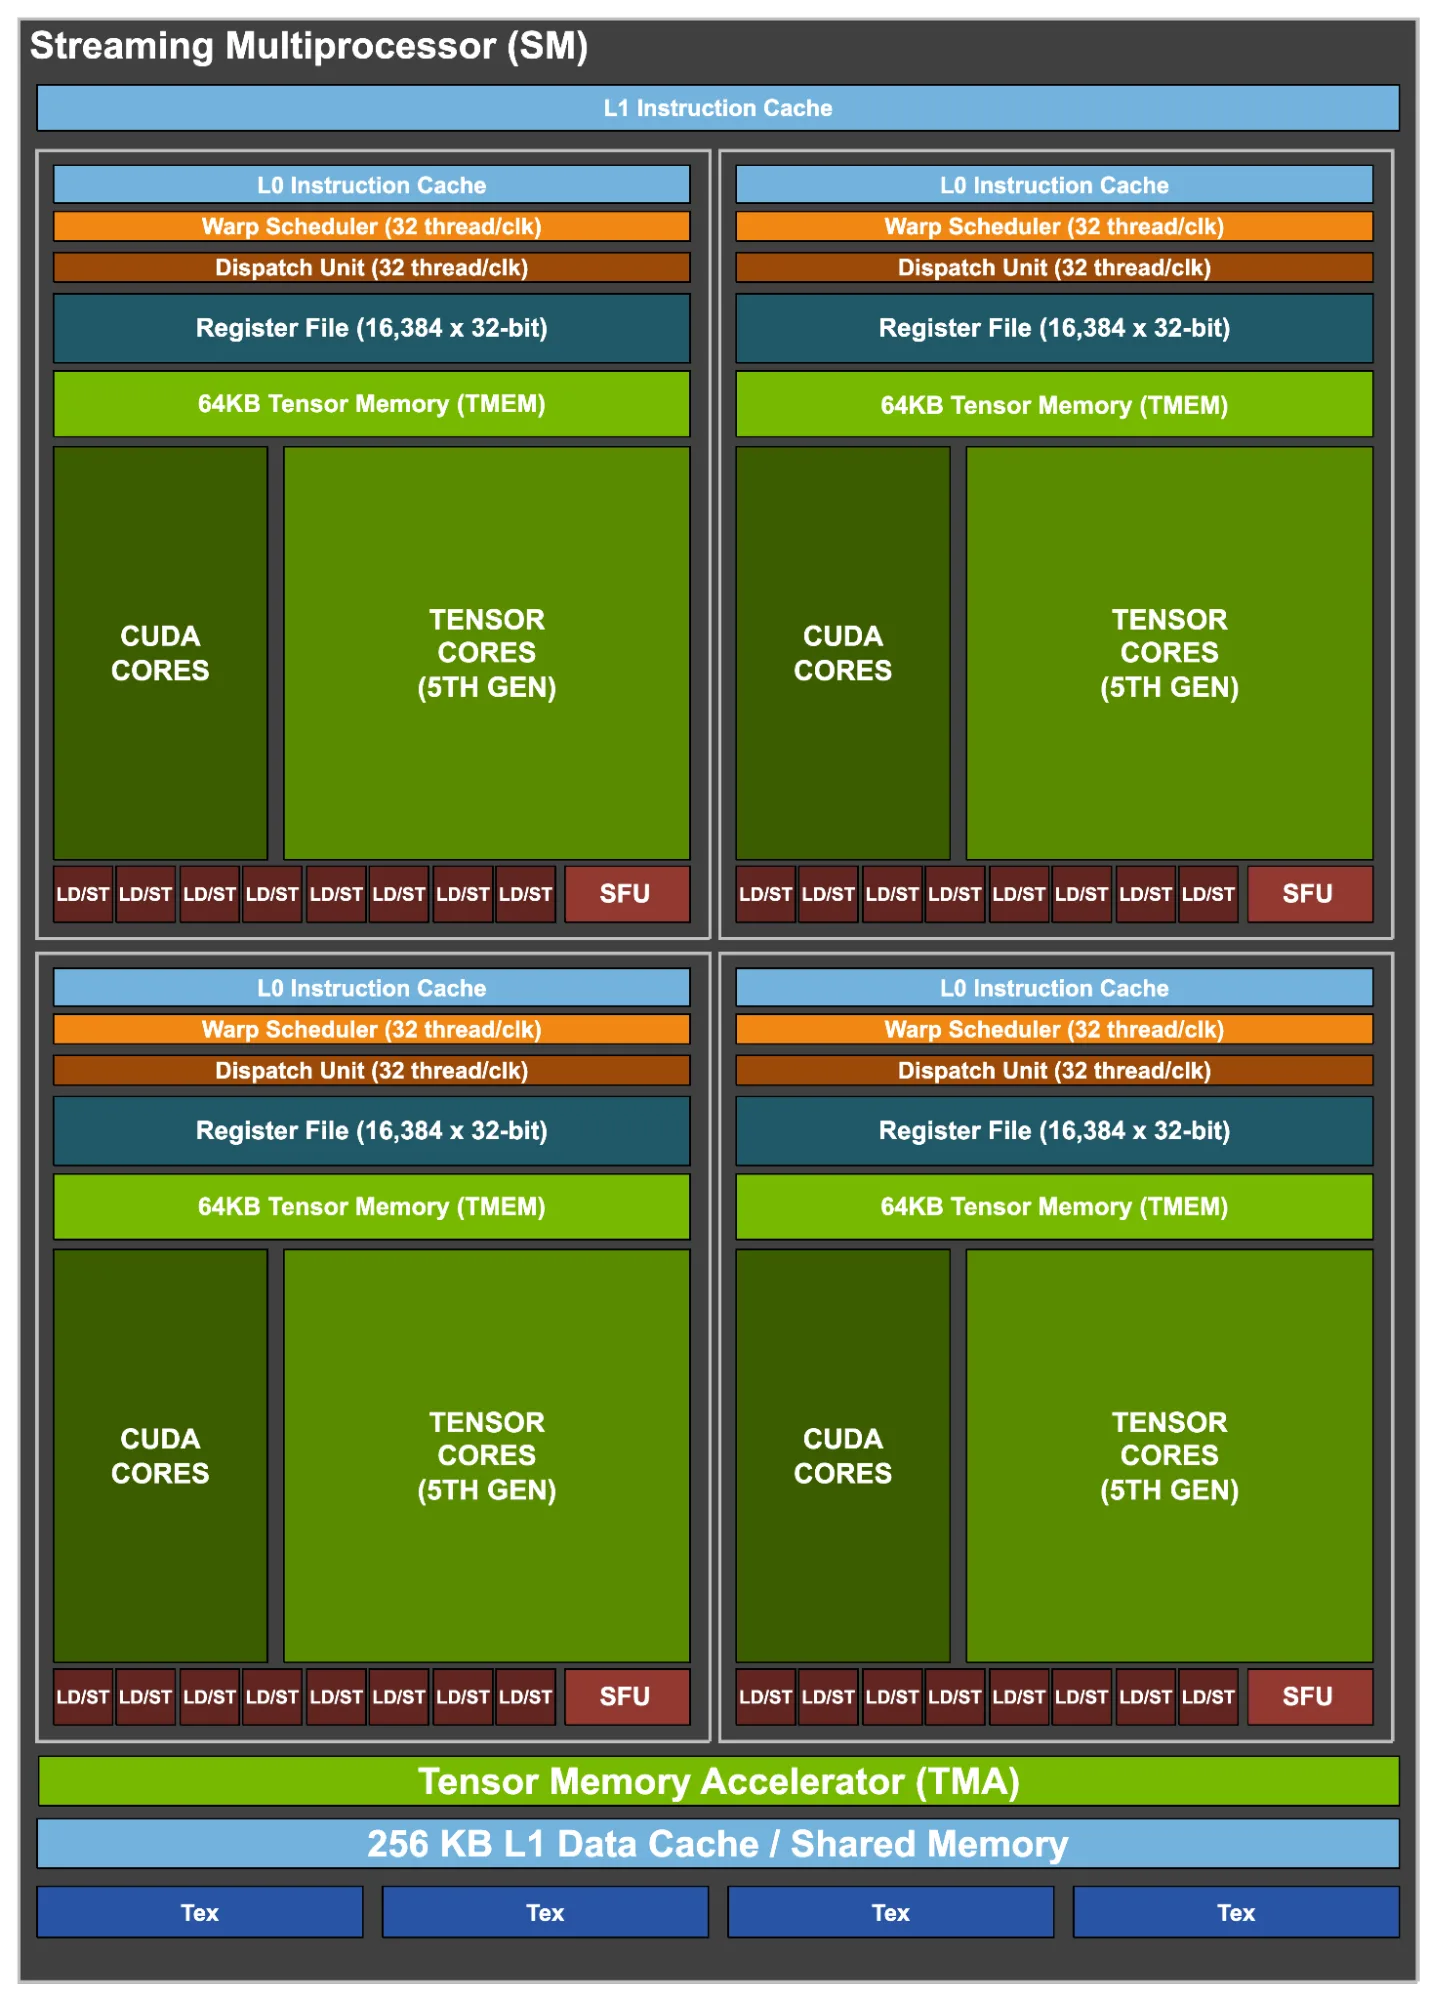
本文所引 Blackwell Ultra 图公开到了块级模块、数量和部分容量。Dispatch Port 拓扑、DU 到后端的完整可达关系和内部仲裁时序,仍然没有公开。
把这些图放在一起,只能得到有限的特定结构:
- Maxwell Tegra X1 与 Pascal GP100 是每个相关 processing block
1 Scheduler + 2 Dispatch Units,并明确给出每 Scheduler 每 clock 最多 dispatch 两条 - Volta 的演讲把 Scheduler 和 Math Dispatch Unit 标为
1 Warp Inst/clk
七、【不】能确定的结论
已有支持
- Nsight 语义中的
selected已表示指令 issued;not_selected表示 eligible 但本拍未被选。 - 发射成功、执行完成、结果可供依赖指令使用,是三个不同边界。
- active mask 决定这条 warp instruction 的哪些 lane 参与执行;inactive lane 不是数据就绪前提。
- issue 同时受 scoreboard 依赖、barrier/control、dispatch 和目标 pipeline 可接受性约束。
- Scoreboard 跟踪 producer/consumer 之间尚未解除的 RAW、WAR、state update 和部分 instruction-level memory ordering 条件;thread synchronization barrier 不是普通 scoreboard dependency。
- 各代官方资料能支持各自图中 Scheduler、Dispatch Unit 和后端模块的数量或标注速率;Volta Hot Chips 图还能支持特定 Math/MIO 局部路径与 MIO Queue 的存在。
只在前提下成立
- 如果两条指令需要同一个、每拍只能接受一份工作的资源,它们会竞争;前提是共享关系和单拍容量都已经被证明。
- 一条指令通过 shared port 的拍数可以写成
ceil(required transactions / transactions accepted per cycle);前提是 transaction 数和每拍接受能力已知。 - 如果一条指令拆成两个 micro-ops,而且都要串行通过每拍容量为 1 的 shared port,那么这条通路至少要花两拍接收它们。
- W0 的 path 忙时,W1 可能成为替代候选;前提是 W1 已 eligible,而且冲突发现时序允许 Scheduler 在相应选择点看到它。
- 微基准可以支持某个资源共享或 multi-cycle 模型;前提是已经用 SASS、依赖链、独立链和混合实验排除了主要替代解释。
公开资料不足
最重要的,但本文无法给出的信息😞
- 一个 Dispatch Unit 可以到达几个 Dispatch Ports。
- 两个 Dispatch Units 的可达 port 集合是否重叠。
- 一个 Dispatch Port 是否连接多个 execution pipelines。
- 一条 execution pipeline 是否可以从多个 ports 接收。
- 一个 Dispatch Unit 是否就是一个物理 port。
- multi-cycle behavior 期间保留的是 port、pipeline entry、内部 queue 还是其他资源。
- Scheduler 能否在晚期 dispatch 冲突发生的同一拍撤回并改选另一个 warp。
- Scheduler 和 Dispatch 之间是否存在未公开的通用 buffer,以及它的深度等细节。
不过,似乎也没必要探索拓扑图,有nsight观测到的metrics已经足够优化性能了
参考资料
- NVIDIA Tegra X1 Maxwell Architecture Whitepaper
- NVIDIA Tesla P100 / Pascal Architecture Whitepaper
- NVIDIA Tesla V100 / Volta Architecture Whitepaper
- NVIDIA Volta Architecture at Hot Chips 29
- NVIDIA Turing GPU Architecture Whitepaper
- NVIDIA A100 Tensor Core GPU Architecture Whitepaper
- NVIDIA Hopper Architecture In-Depth
- Inside NVIDIA Blackwell Ultra
- Nsight Compute Profiling Guide
- Nsight Compute:Instructions & Dependencies
- CUDA Programming Guide:Independent Thread Scheduling
- CUDA Binary Utilities:cuobjdump 与 nvdisasm
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking
- NVIDIA Developer Forums:FFMA、HMMA 与 multi-cycle dispatch 说明